KI-Modelle · Seite 3
 KI-Bild
Beam veröffentlicht: 501 Milliarden Parameter und 1 Million Tokens Kontext
Reflection veröffentlichte das Modell Beam mit 501 Milliarden Parametern am 16. Oktober 2026 unter der Apache-2.0-Lizenz auf Hugging Face. Das textbasierte Modell unterstützt ein Kontextfenster von 1 Million Tokens; für den Betrieb auf eigener Infrastruktur ist Hardware mit viel Speicher erforderlich.
 KI-Bild
Muse Spark Open vorgestellt: multimodales Modell mit 816 Milliarden Parametern
Metas Modell Muse Spark Open kann neben Text auch Bild-, Audio- und Videoeingaben verarbeiten. Das Modell verfügt über insgesamt rund 816 Milliarden Parameter, ist auf Coding-Aufgaben ausgerichtet und benötigt Hardware mit sehr viel Speicher.
FLUX.3 Image Klein ist da: Layout-gesteuerte Generierung in Diffusers
Das Modell FLUX.3 Image Klein von Black Forest Labs ist seit dem 15. Oktober in Hugging Face Diffusers verfügbar. Neben der Generierung aus Text und mehreren Referenzbildern ermöglicht es, die Position von Szenenelementen mithilfe von Boxen festzulegen.
NVIDIA Nemotron 3.5 Super VL ist da: offenes Modell mit 120 Milliarden Parametern
NVIDIA hat Nemotron 3.5 Super VL mit 120 Milliarden Parametern sowie zwei Bolt-Modelle angekündigt. Super VL und Bolt 74B-A9B sind verfügbar, Bolt E4B soll am 23. Oktober erscheinen.
 KI-Bild
LFM2.5-24B-A2B veröffentlicht: lokales Agentenmodell mit 2 Mrd. aktiven Parametern
Liquid AI hat am 13. Oktober das Modell LFM2.5-24B-A2B angekündigt. Das Modell mit insgesamt 24 Milliarden Parametern und 2 Milliarden aktiven Parametern pro Token richtet sich an lokal laufende Agenten, die Tools nutzen können.
Gemini 4 Argon vorgestellt: 3D-Simulationsworkflows für die Robotik
Google DeepMind stellte Gemini 4 Argon am 13. Oktober für Robotik und physikalisches Denken vor. Der Beitrag zeigt Beispiele, wie das Modell aus realen Bildern Simulationsszenen in MuJoCo erstellt.
Gemini 4 Argon ist da: Google zeigt 3D-Szenenerstellung mit Blender
Google hat Gemini 4 Argon weltweit verfügbar gemacht. Das Unternehmen veröffentlichte Beispiele, in denen das Modell mit Antigravity und Blender 3D-Szenen erstellt, und gab Einführungspreise für die API bekannt.
 KI-Bild
Meta gibt die Modelle Muse Wonder und Wonder Full frei
Meta hat die Modelle Muse Wonder und Muse Wonder Full für Muse-Code-Abonnenten freigegeben; Wonder ist außerdem über die Meta Model API verfügbar. Das Unternehmen plant, Wonder künftig im Muse-Agenten einzusetzen, hat aber keinen Zeitplan für die Integration genannt.
 KI-Bild
Blueprints AI will diese Woche Version 2 veröffentlichen
Blueprints AI plant, diese Woche die zweite Generation seiner Software zu veröffentlichen, die aus einer Skizze oder Projektbeschreibung Architektur- und Ingenieurzeichnungen erstellen kann. Das Unternehmen gibt an, dass Änderungen im gesamten Projekt übernommen und lokale Bauvorschriften geprüft werden.
 KI-Bild
Odyssey-3 ist verfügbar: Interaktive Welten in Echtzeit aus Text
Odyssey hat sein Weltmodell Odyssey-3 als öffentliche Forschungsvorschau verfügbar gemacht. Die kostenlose Online-Demo erstellt Umgebungen in Echtzeit per Textprompt; Entwickler müssen den API-Zugang beantragen.
 KI-Bild
Ai2-GPU-Scheduler teilt Forschungsprojekten Zeitbudgets zu
Ai2 stellte am 9. Oktober einen Scheduler für Forschungscluster vor, der GPU-Zeit mithilfe von Projektbudgets und Regeln zur fairen Verteilung verwaltet. Nach Angaben der Institution gingen Reparaturen, die menschliches Eingreifen erfordern, um 74 Prozent zurück.
 KI-Bild
NVIDIA Omniverse: Simulationsbeispiele mit Astra-Agenten vorgestellt
NVIDIA hat Beispiele für KI-gestützte Simulationen veröffentlicht, die mit Omniverse-Bibliotheken entwickelt wurden. Die Projekte reichen von Tests für Lagerroboter bis zu digitalen Zwillingen und zeigen, wie Agenten unter Anleitung von Entwicklern eingesetzt werden.
 KI-Bild
Claude Dashboards und Motion: Live-Dashboards und Videos aus Text
Anthropic hat am 8. Oktober zwei Beta-Funktionen für Claude angekündigt: Dashboards, die Datenquellen automatisch aktualisieren, und Motion, das aus Text, Diagrammen und Bildern editierbare Erklärvideos erstellt.
 KI-Bild
Gemini Enterprise-Agent angekündigt: Arbeitsaufgaben über eine Oberfläche erledigen
Google hat am 8. Oktober 2026 einen KI-Agenten für Gemini Enterprise angekündigt, der Aufgaben in verschiedenen Anwendungen übernehmen kann. Der Agent lässt sich mit Unternehmensdaten und -tools verbinden und befindet sich derzeit in einer exklusiven Vorschau für Unternehmenskunden.
 KI-Bild
Vidu Q4 Preview vorgestellt: 4K-Video und Referenz-Audio von Shengshu
Shengshu Technology hat Vidu Q4 Preview am 7. Oktober vorgestellt. Das Unternehmen nennt 4K- und 10-Bit-Video, Referenz-Audio und die Steuerung von Szenen mit bis zu 15 Bildern. Die Preise beginnen bei 0,045 US-Dollar pro Sekunde.
 KI-Bild
GPT-6 bringt interaktive Oberflächen und Tools in ChatGPT
OpenAI hat am 7. Oktober damit begonnen, GPT-6 mit der Funktion Intelligent UI in ChatGPT einzuführen. Die Funktion kann Antworten als Diagramme, Formulare und interaktive Tools darstellen. Der Zugang startet heute für kostenpflichtige Tarife und wird morgen auf kostenlose Tarife ausgeweitet.
 KI-Bild
Stiller Schachzug von Google: Nano-Banana-2.1-Gerücht widerspricht offiziellen Unterlagen
Tech-Blogs behaupten, Google habe das neue Bildmodell Nano Banana 2.1 still veröffentlicht; die offizielle Gemini-API-Dokumentation von Google listet diese Version jedoch nicht.
 KI-Bild
Mistral Large 4 vorgestellt: Europäisches Billionen-Parameter-Modell in der Vorschau
Mistral hat die Vorschau von Large 4 veröffentlicht, einem Modell mit einer Billion Parametern. Das Modell zeigt starke Ergebnisse bei Cybersicherheitsaufgaben und der Analyse technischer Visualisierungen; die Gewichte sollen Ende Oktober veröffentlicht werden.
 KI-Bild
Reactor erhält Unterstützung von NVIDIA: Investitionen in Echtzeit-3D-Infrastruktur
Reactor gab am 5. Oktober bekannt, dass NVentures und Sapphire Ventures an der Series-A-Finanzierungsrunde teilgenommen haben. Damit beläuft sich die vom Unternehmen angegebene Gesamtfinanzierung auf 74 Millionen Dollar. Reactor entwickelt Infrastruktur für interaktive 3D-Umgebungen.
 KI-Bild
OpenAI versieht geeignete ChatGPT- und Codex-Texte in der EU mit Wasserzeichen
OpenAI wird in den kommenden Wochen das unsichtbare textGrain-Wasserzeichen bei geeigneten Textausgaben berechtigter ChatGPT- und Codex-Nutzer in der EU einsetzen. API-Kunden können die Funktion bei ausgewählten Modellen weltweit optional aktivieren.
 KI-Bild
Reka AI stellt Rho-1 vor: Text, Bild, Video und Robotersteuerung in einem Modell
Reka AI hat eine Forschungsvorschau von Rho-1 veröffentlicht, einem Modell, das Text, Bild, Video und Robotersteuerung in einem einzigen neuronalen Netzwerk vereint. Das Modell mit 19 Milliarden Parametern kann Videos in Echtzeit generieren und auf neue Anweisungen reagieren, während der Stream läuft.
 KI-Bild
URP 2026 Design + AI Hackathon: Entwürfe für wandelbare Möbel
Die Universidad Ricardo Palma richtet am 9. Oktober den ersten Design + AI Hackathon URP 2026 aus. Teams aus Studierenden und Absolventen entwickeln Vorschläge für vielseitige, wandelbare Möbel, die einen konkreten Bedarf decken.
 KI-Bild
NVIDIA DGX Spark 64GB vorgestellt: Lokaler KI-Computer mit Blender-Unterstützung
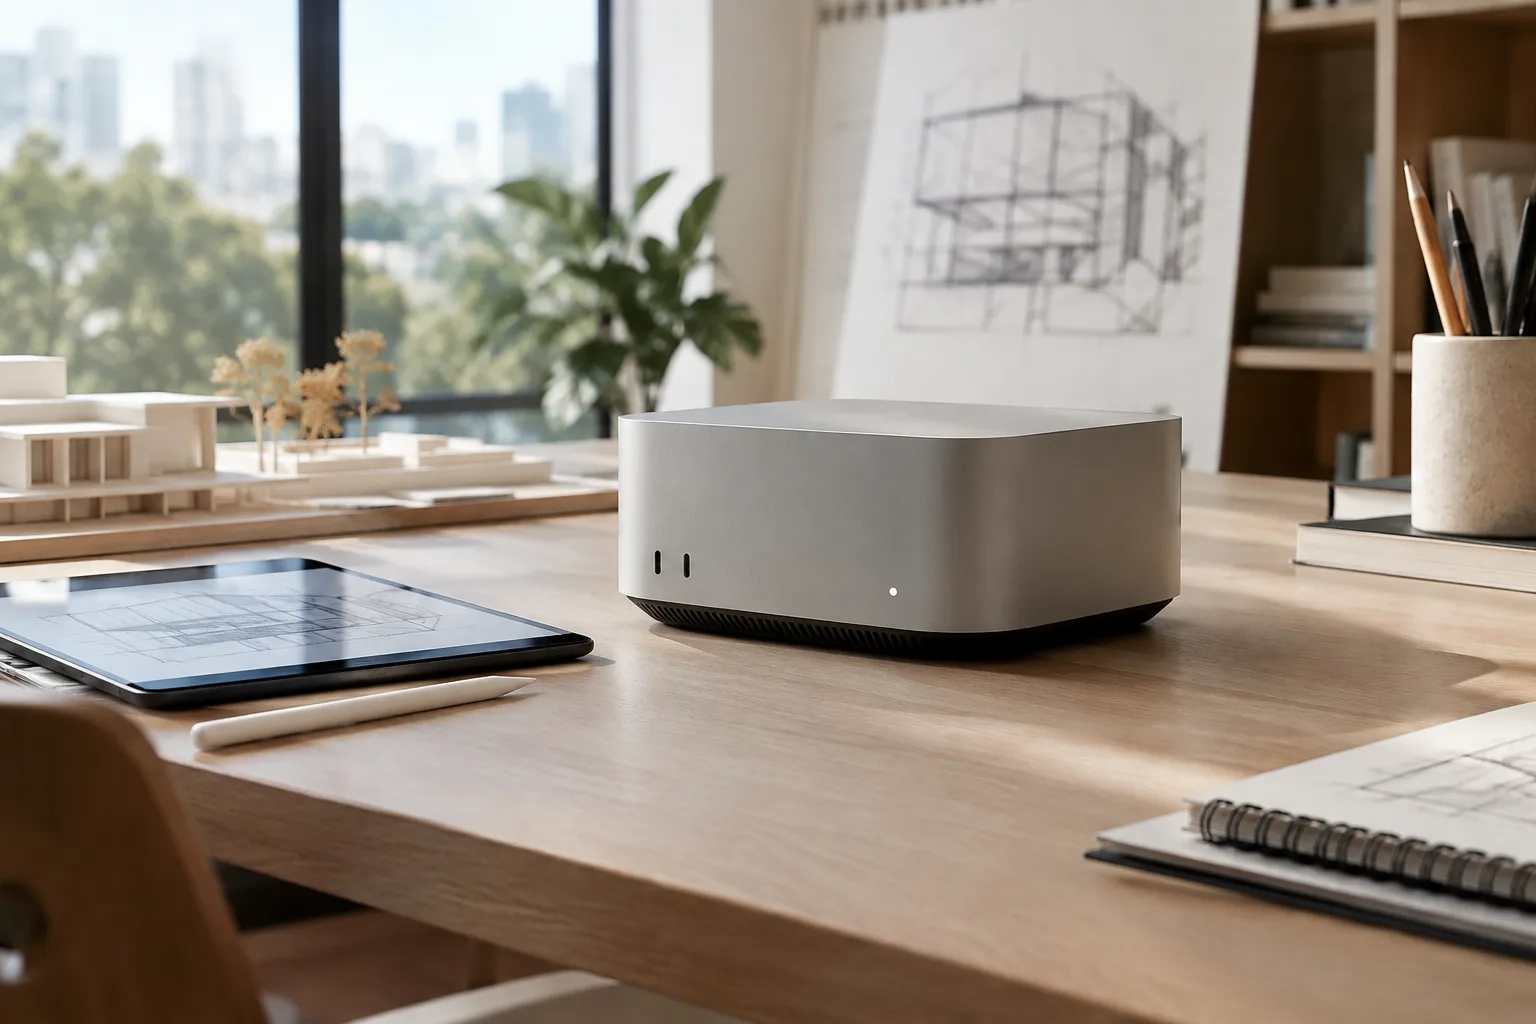
NVIDIA hat eine neue DGX-Spark-Konfiguration mit 64GB einheitlichem Speicher angekündigt. Das Gerät kommt am 23. Oktober für 4.999 US-Dollar auf den Markt, und Blender wird eine der ersten großen Kreativ-Software-Lösungen mit Unterstützung sein.
 KI-Bild
Flux 3 Image ist da: Mehrstufige Bearbeitung und Bildgenerierung in 4K
Black Forest Labs hat Flux 3 Image veröffentlicht, ein Modell zur Bildgenerierung und -bearbeitung aus der Flux-3-Familie. Es unterstützt mehrstufige Bearbeitung, bis zu 10 Referenzbilder und eine Ausgabeauflösung von bis zu 4K.