Modelos de IA · Página 3
 Imagen IA
Se publica Beam: 501.000 millones de parámetros y contexto de 1 millón de tokens
El modelo Beam de Reflection, con 501.000 millones de parámetros, se publicó en Hugging Face el 16 de octubre de 2026 con licencia Apache 2.0. Este modelo centrado en texto admite un contexto de 1 millón de tokens; ejecutarlo en infraestructura propia requiere hardware con mucha memoria.
 Imagen IA
Presentan Muse Spark Open: un modelo multimodal de 816.000 millones de parámetros
El modelo Muse Spark Open de Meta puede procesar entradas de texto, imágenes, audio y video. Con cerca de 816.000 millones de parámetros totales, se centra en tareas de programación y requiere hardware con mucha memoria.
FLUX.3 Image Klein ya está disponible: el control de composición llega a Diffusers
El modelo FLUX.3 Image Klein de Black Forest Labs estuvo disponible en Hugging Face Diffusers el 15 de octubre. Además de generar imágenes a partir de texto y de varias imágenes de referencia, permite definir la posición de los elementos de la escena mediante cajas.
NVIDIA Nemotron 3.5 Super VL ya está disponible: modelo abierto de 120.000 millones de parámetros
NVIDIA anunció Nemotron 3.5 Super VL, con 120.000 millones de parámetros, y dos modelos Bolt. Super VL y Bolt 74B-A9B ya están disponibles; el lanzamiento de Bolt E4B está previsto para el 23 de octubre.
 Imagen IA
LFM2.5-24B-A2B ya está disponible: un modelo de agentes local con 2.000 millones de parámetros activos
Liquid AI anunció el modelo LFM2.5-24B-A2B el 13 de octubre. Con 24.000 millones de parámetros totales y 2.000 millones activos por token, está diseñado para agentes locales capaces de usar herramientas.
Gemini 4 Argon: flujos de simulación 3D para robótica
Google DeepMind presentó Gemini 4 Argon el 13 de octubre para robótica y razonamiento físico. La publicación incluye ejemplos de creación de escenas de simulación en MuJoCo a partir de imágenes reales.
Gemini 4 Argon ya está disponible: Google muestra escenas 3D en Blender
Google habilitó Gemini 4 Argon a nivel mundial. La compañía compartió ejemplos de escenas 3D creadas con el modelo mediante Antigravity y Blender, y anunció precios promocionales para la API.
 Imagen IA
Meta abre el acceso a los modelos Muse Wonder y Wonder Full
Meta abrió los modelos Muse Wonder y Muse Wonder Full a los suscriptores de Muse Code; Wonder también está disponible a través de Meta Model API. La compañía planea utilizar Wonder en su agente Muse, pero no ha dado una fecha para la integración.
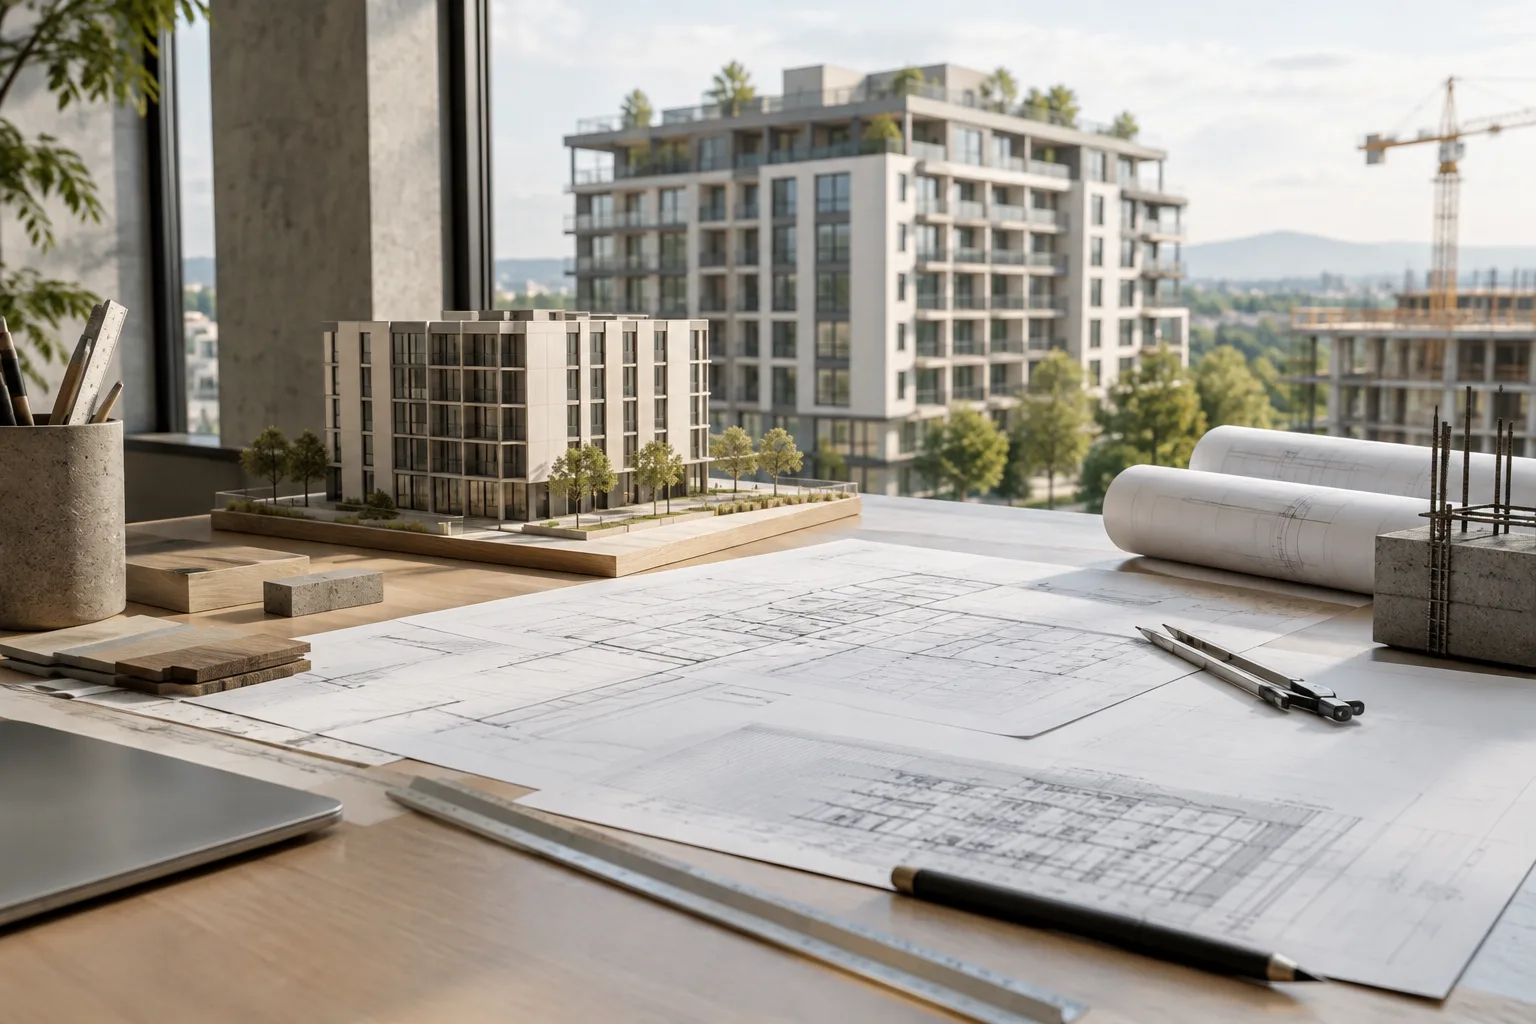 Imagen IA
Blueprints AI prevé lanzar su segunda generación esta semana
Blueprints AI planea lanzar esta semana la segunda generación de su software, capaz de crear planos arquitectónicos y de ingeniería a partir de un boceto o una descripción del proyecto. La empresa afirma que los cambios se aplicarán a todo el proyecto y que se comprobará el cumplimiento de las normas de construcción locales.
 Imagen IA
Odyssey-3 ya está disponible: mundos interactivos en tiempo real a partir de texto
Odyssey puso a disposición del público su modelo de mundo Odyssey-3 como vista previa de investigación. La demo gratuita en línea crea entornos en tiempo real mediante instrucciones de texto; los desarrolladores deben solicitar acceso a la API.
 Imagen IA
El planificador de GPU de Ai2 asigna presupuestos de tiempo a proyectos
El 9 de octubre, Ai2 presentó un planificador que gestiona el tiempo de GPU en clústeres de investigación mediante presupuestos por proyecto y reglas de reparto equitativo. La institución informa que las reparaciones que requieren intervención humana se redujeron un 74 %.
 Imagen IA
NVIDIA Omniverse: se comparten ejemplos de simulación con agentes Astra
NVIDIA compartió ejemplos de simulación asistida por inteligencia artificial desarrollados con bibliotecas de Omniverse. Desde pruebas con robots de almacén hasta gemelos digitales, los proyectos muestran cómo se usan los agentes bajo la dirección de desarrolladores.
 Imagen IA
Claude Dashboards y Motion: paneles dinámicos y videos a partir de texto
Anthropic anunció el 8 de octubre dos funciones beta para Claude: Dashboards, que crea paneles actualizados desde fuentes de datos, y Motion, que genera videos explicativos editables a partir de texto, diagramas e imágenes.
 Imagen IA
Se anuncia el agente de Gemini Enterprise: gestionará tareas laborales desde una sola interfaz
Google anunció el 8 de octubre de 2026 un agente de IA en Gemini Enterprise capaz de realizar tareas en distintas aplicaciones. Puede conectarse a datos y herramientas de la empresa y, por ahora, está disponible en vista previa privada para clientes empresariales.
 Imagen IA
Vidu Q4 Preview llega con video 4K y audio de referencia
Shengshu Technology anunció Vidu Q4 Preview el 7 de octubre. La compañía señaló que el modelo ofrece video 4K y de 10 bits, admite audio de referencia y permite controlar escenas con hasta 15 imágenes; el precio parte de 0,045 dólares por segundo.
 Imagen IA
GPT-6 lleva interfaces interactivas y herramientas a ChatGPT
OpenAI comenzó a incorporar GPT-6 en ChatGPT el 7 de octubre con la función Intelligent UI. La función puede presentar respuestas mediante gráficos, formularios y herramientas interactivas; el acceso comienza hoy con los planes de pago y mañana se amplía a los planes gratuitos.
 Imagen IA
Movimiento silencioso de Google: el supuesto Nano Banana 2.1 contradice los documentos oficiales
Blogs tecnológicos sugirieron que Google lanzó silenciosamente un nuevo modelo de imagen llamado Nano Banana 2.1; sin embargo, la documentación oficial de la Gemini API de Google no incluye esta versión.
 Imagen IA
Mistral Large 4 presentado: modelo europeo de un billón de parámetros en vista previa
Mistral ha publicado la vista previa de Large 4, un modelo con un billón de parámetros. El modelo muestra resultados sólidos en tareas de ciberseguridad y análisis de imágenes técnicas; los pesos se compartirán a finales de octubre.
 Imagen IA
Inversión de NVIDIA en Reactor: apuesta por la infraestructura 3D en tiempo real
Reactor anunció el 5 de octubre la participación de NVentures y Sapphire Ventures en su ronda de Serie A. La inversión total comunicada por la empresa asciende a 74 millones de dólares; Reactor desarrolla infraestructura para entornos 3D interactivos.
 Imagen IA
OpenAI añadirá marcas de agua a textos elegibles de ChatGPT y Codex en la UE
En las próximas semanas, OpenAI empezará a incluir la marca de agua invisible textGrain en las respuestas de texto elegibles de usuarios de ChatGPT y Codex en la UE. Los clientes de la API podrán activar esta opción en determinados modelos en todo el mundo.
 Imagen IA
Reka AI presenta Rho-1: texto, imagen, video y control robótico en un solo modelo
Reka AI publicó la vista previa de investigación de Rho-1, un modelo que combina texto, imágenes, video y control robótico en una sola red neuronal. El modelo, de 19.000 millones de parámetros, puede generar video en tiempo real y responder a nuevas instrucciones mientras continúa la transmisión.
 Imagen IA
URP 2026 Design + AI Hackathon: diseño de muebles transformables
La Universidad Ricardo Palma acogerá el primer Design + AI Hackathon URP 2026 el 9 de octubre. Equipos de estudiantes y graduados desarrollarán propuestas de muebles multifuncionales y transformables que respondan a una necesidad real.
 Imagen IA
NVIDIA DGX Spark 64GB presentado: llega la IA local con soporte para Blender
NVIDIA anunció una nueva configuración de DGX Spark con 64GB de memoria unificada. El equipo saldrá a la venta el 23 de octubre a partir de 4.999 dólares, y Blender será uno de los primeros grandes software creativos en ofrecer soporte.
 Imagen IA
Flux 3 Image llega: edición en varios pasos e imágenes en 4K
Black Forest Labs lanzó Flux 3 Image, el modelo de generación y edición de imágenes de la familia Flux 3. El modelo permite editar en varios pasos, usar hasta 10 imágenes de referencia y generar resultados de hasta 4K.