En resumen
- Isaac Lab incluye tareas de marcha para Microduck en terrenos llanos e irregulares.
- La política recibe 61 valores de observación y genera 14 posiciones articulares.
- Tras el entrenamiento, la política puede exportarse en formato ONNX y cargarse en el entorno de ejecución integrado de Microduck.
- Microduck Arena compara políticas en tareas compartidas, siempre que cumplan los requisitos de interfaz y tamaño de archivo.
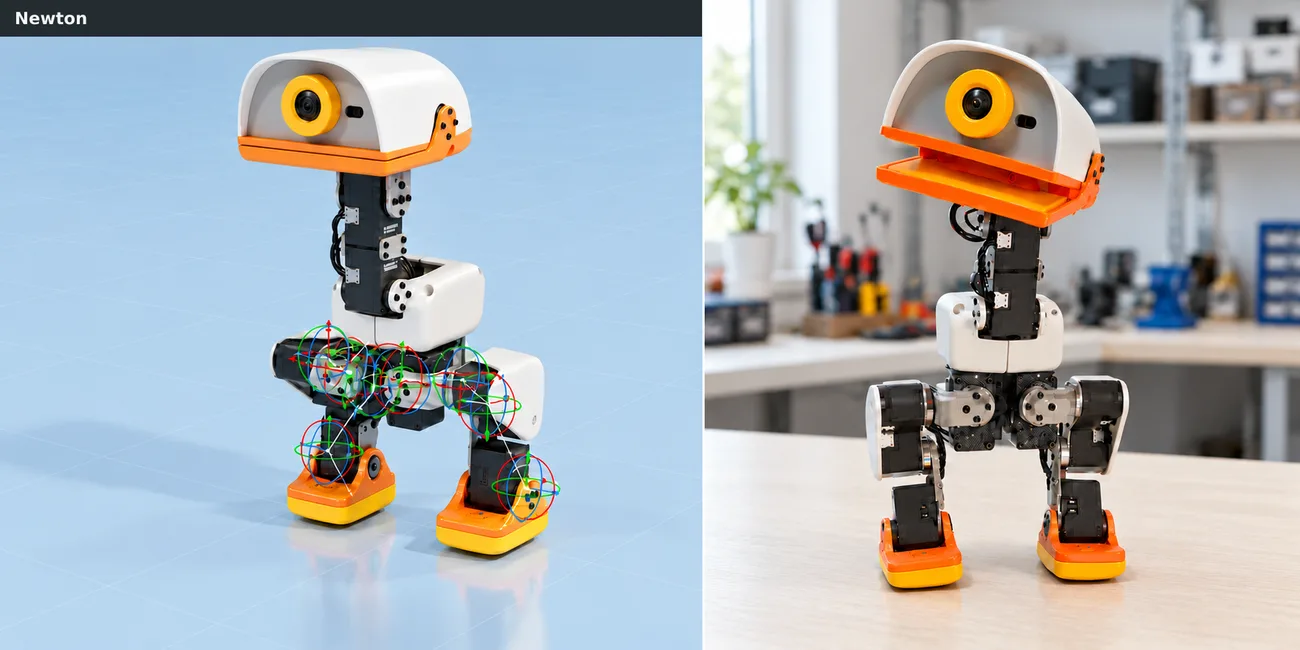
En una guía comunitaria publicada en el blog de Hugging Face el 21 de octubre de 2026, colaboradores de NVIDIA explicaron un flujo de entrenamiento que va de la simulación al hardware real para el robot Microduck de Pollen Robotics y Hugging Face, con Isaac Lab 3.0 y Newton. La guía recorre paso a paso cómo simular una política de marcha con GPU, evaluarla y transferirla al robot físico como archivo ONNX.
¿Qué entornos de entrenamiento hay disponibles para Microduck?
Isaac Lab incluye el modelo del robot Microduck, así como definiciones de escenas, observaciones y acciones, ajustes de recompensa y opciones de aleatorización. Además de la tarea de marcha sobre terreno llano, ofrece una opción para terrenos irregulares que incluye escaleras, pendientes y superficies desiguales. Según la guía, la política utiliza 61 valores de observación y genera 14 posiciones articulares.
La interfaz utilizada en la simulación debe ser coherente con la política exportada y cargada en el robot. En particular, el orden de las observaciones, la normalización y la escala de las acciones deben coincidir con los ajustes del entrenamiento. Estas condiciones ayudan a conservar, durante la fase de hardware, la estructura de entradas y salidas que la política aprendió durante el entrenamiento.
¿Cómo influyen Newton y la aleatorización en la simulación?
La guía utiliza el solver MJWarp de Newton y Better Actuator Models (BAM), basados en Newton. Este enfoque busca representar en la simulación el comportamiento de los servos. También incorpora un ajuste de holgura de engranajes para incluir en los escenarios de entrenamiento el juego mecánico de las articulaciones.
Para preparar la política ante distintas condiciones físicas, durante el entrenamiento se varían la masa y el centro de gravedad, la fricción del suelo, las inercias articulares, los offsets de los encoders, el voltaje de la batería y el retardo de los comandos. También se modifican las condiciones del terreno y se aplican empujes a los robots. Estas variables amplían la variedad de situaciones que pueden surgir en la simulación; para lograr un buen rendimiento en el hardware real, la guía destaca la importancia de transferir correctamente los ajustes de recursos, observaciones y acciones.
Entrenamiento con GPU y transferencia al robot mediante ONNX
Isaac Lab puede ejecutar en paralelo entornos de simulación en la GPU. La guía informa de un rendimiento de entrenamiento de hasta 1,25 millones de pasos por segundo con terreno irregular y holgura de engranajes activados. Los comandos de ejemplo utilizan 4.096 entornos de simulación; también se explica cómo distribuir el entrenamiento entre 16 GPU. Estas cifras corresponden a la configuración de la guía y no garantizan los mismos resultados en otro hardware.
Al evaluar la política, el flujo de reproducción RSL-RL de Isaac Lab exporta automáticamente archivos TorchScript y ONNX. Para transferirla a un Microduck real se utiliza el archivo ONNX. La guía también explica cómo copiar y cargar el archivo en el robot y probar acciones como ponerse de pie, caminar despacio, girar y detenerse.
Las políticas ONNX pueden enviarse a Microduck Arena para compararlas en tareas compartidas. Arena acepta modelos con 61 valores de observación y 14 de acción, y un tamaño máximo de 64 MiB. La guía también contempla la opción de compartir la configuración de entrenamiento y el modelo en Hugging Face Hub.
Efectos en los flujos de trabajo de arquitectura y visualización
El enfoque de esta guía no es el modelado arquitectónico, sino el entrenamiento robótico y la transferencia a un robot real de una política desarrollada en simulación. Por eso, más que ofrecer una función directa de diseño arquitectónico o visualización, presenta un flujo de entrenamiento práctico para equipos que trabajan en robótica e inteligencia artificial física. La fuente también señala que, más adelante, podrían explorarse tareas de percepción con profundidad de cámara y distintos ejemplos de manipulación.
Los equipos que quieran evaluar este flujo de trabajo deben comprobar primero los requisitos de hardware: para entrenar se necesita una estación de trabajo Linux, una GPU NVIDIA compatible y el controlador correspondiente. La guía describe Isaac Lab como un framework de código abierto, pero no especifica los detalles de la licencia ni el costo total. Por ello, es importante revisar por separado la compatibilidad técnica y las condiciones de licencia.
Fuentes
1 fuenteNo republicamos los textos de las fuentes; las citas breves van marcadas y el resto es resumen y comentario propios.
El valor práctico de la guía está en reunir en un solo flujo los pasos de simulación, entrenamiento, exportación y prueba en hardware físico para la marcha de un robot. Para los equipos que trabajan en robótica o inteligencia artificial física en Turquía, el primer punto que conviene revisar es si la estación de trabajo Linux utilizada cumple los requisitos de GPU NVIDIA compatible y controlador.
Para los equipos de arquitectura y archviz, no es una herramienta de producción directa; resulta más pertinente para quienes se interesan en entrenar comportamientos robóticos en simulación. Como la fuente no detalla la licencia ni el costo total, conviene que los equipos no elaboren presupuestos ni planes de producción antes de aclarar las condiciones de licencia y la compatibilidad del hardware.
Preguntas frecuentes
¿En qué formato se transfiere al robot la política de Microduck entrenada con Isaac Lab?
La guía indica que el flujo de reproducción RSL-RL de Isaac Lab genera archivos TorchScript y ONNX. Para transferir la política a un Microduck físico se utiliza el archivo ONNX.
¿Cuántos valores de observación y acción utiliza la política de marcha de Microduck?
La política recibe 61 valores de observación y genera 14 posiciones articulares. La interfaz debe mantenerse coherente durante el entrenamiento y en la fase de hardware.
¿Qué modelos acepta Microduck Arena?
Arena acepta modelos ONNX con 61 valores de observación y 14 de acción, cuyo tamaño no supere los 64 MiB.